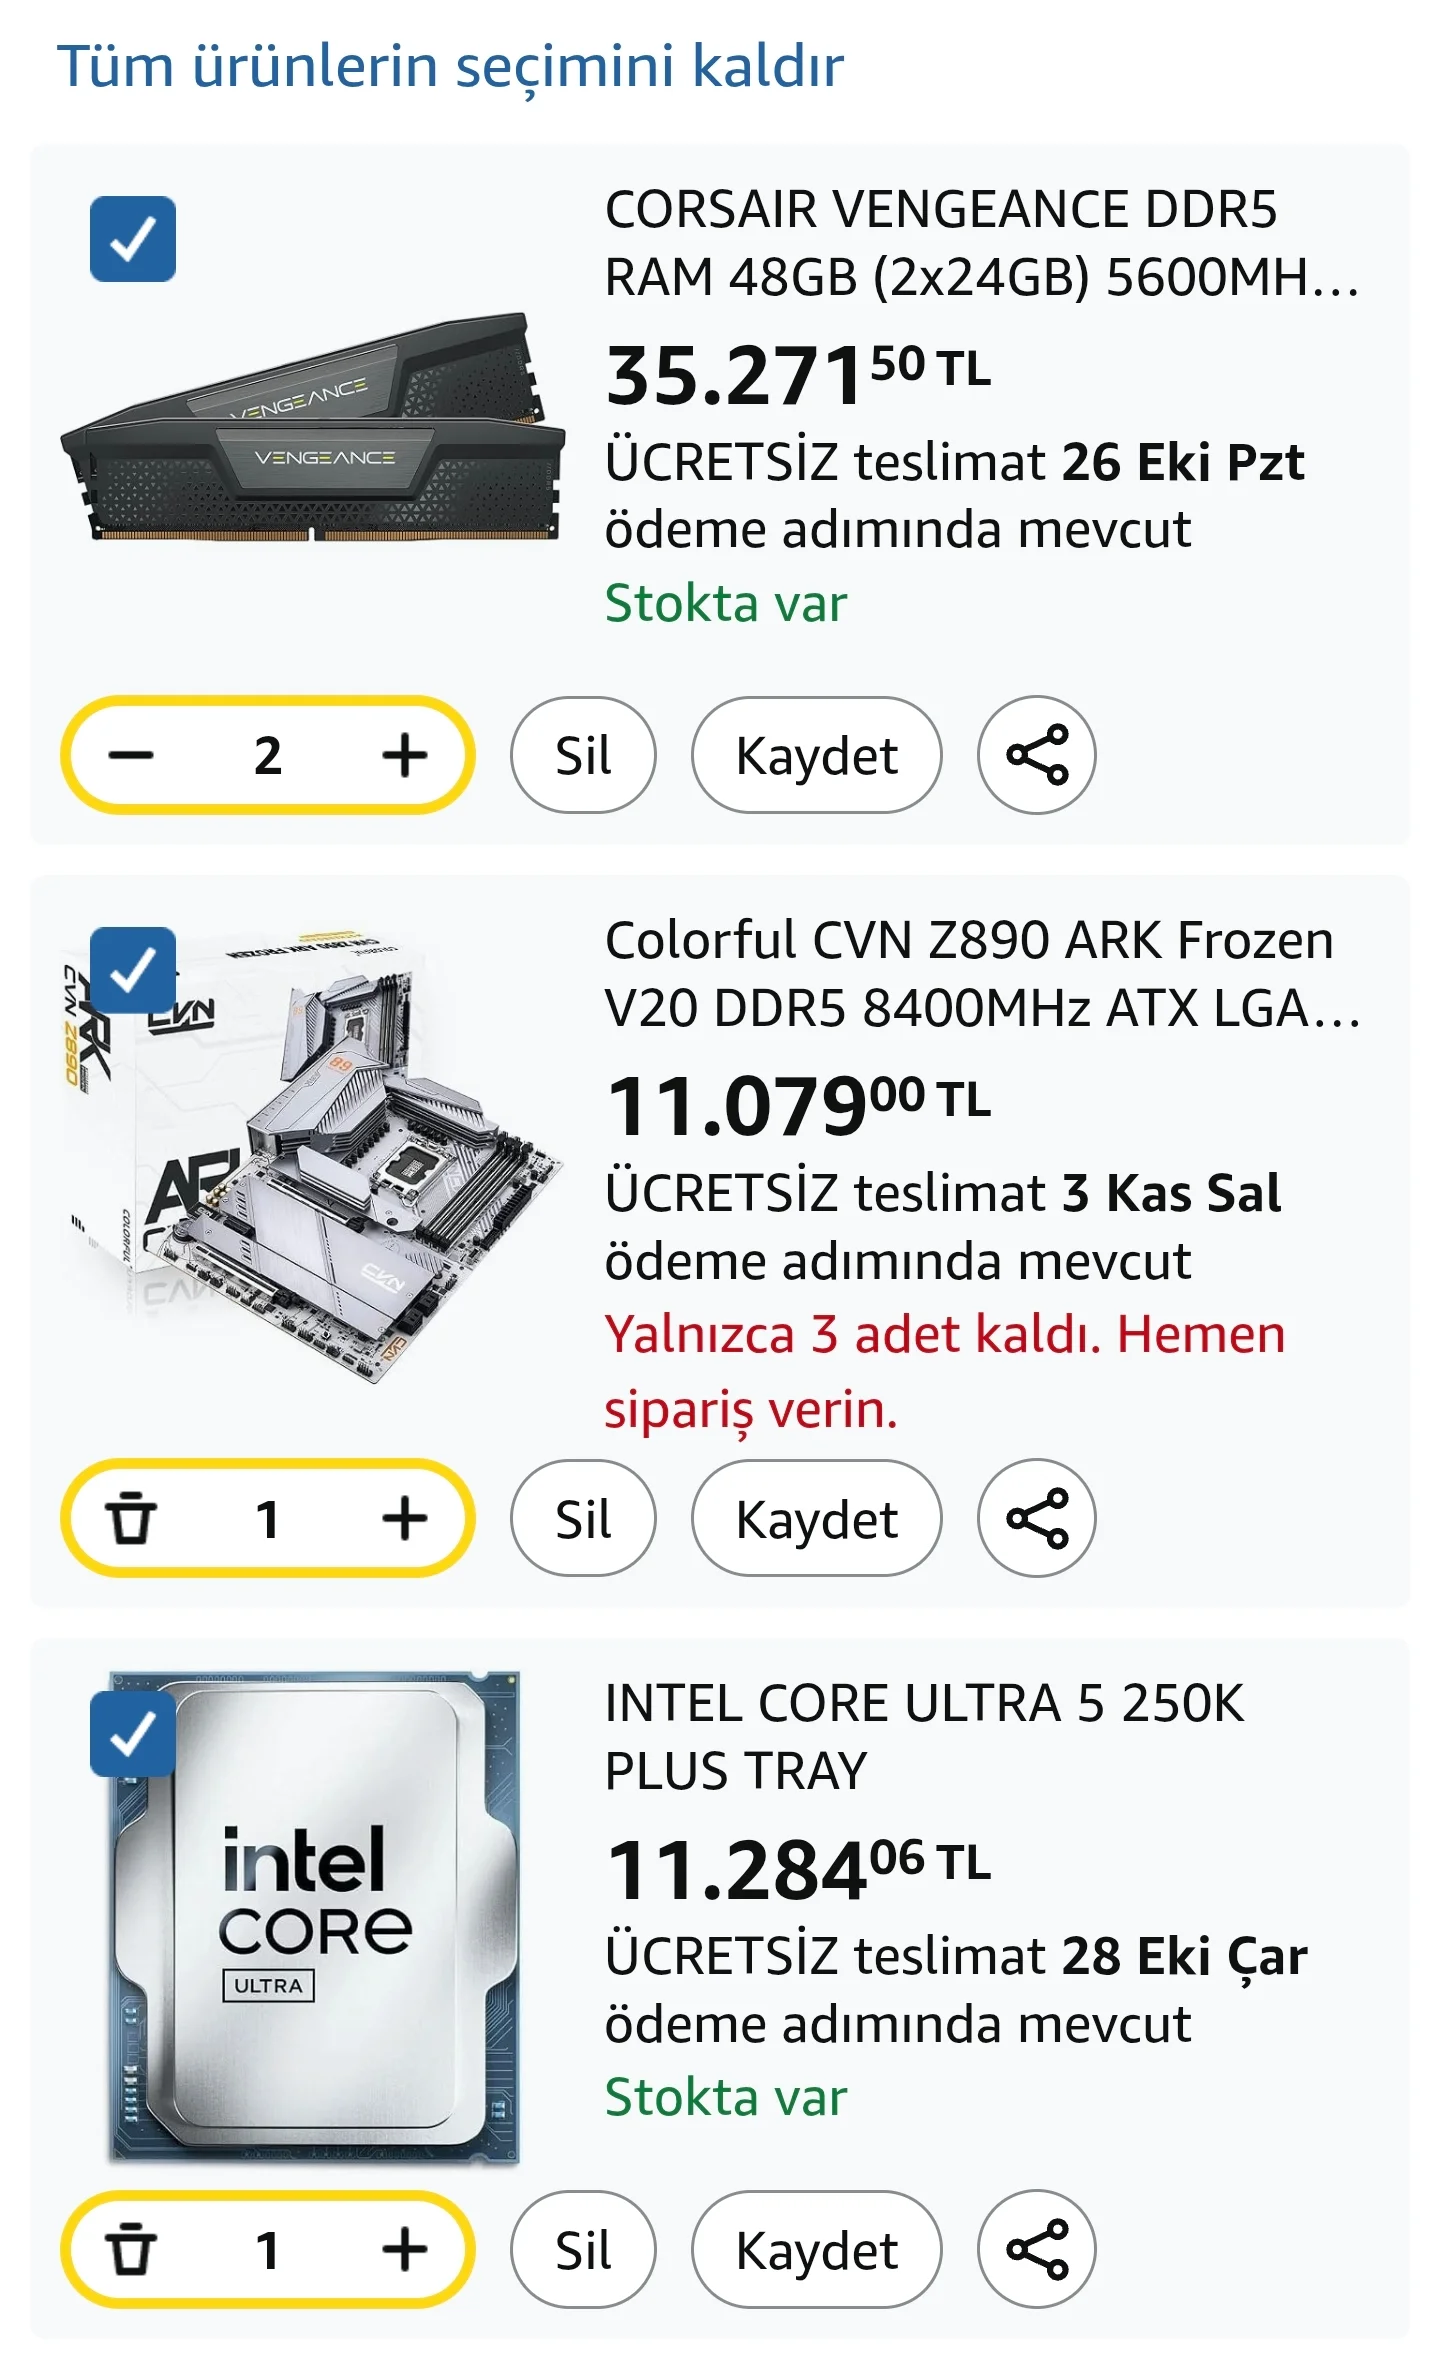
Amazon'dan ekran kartsız şöyle bir ai sistem toplamayı düşünüyorum sizce nasıl olur?
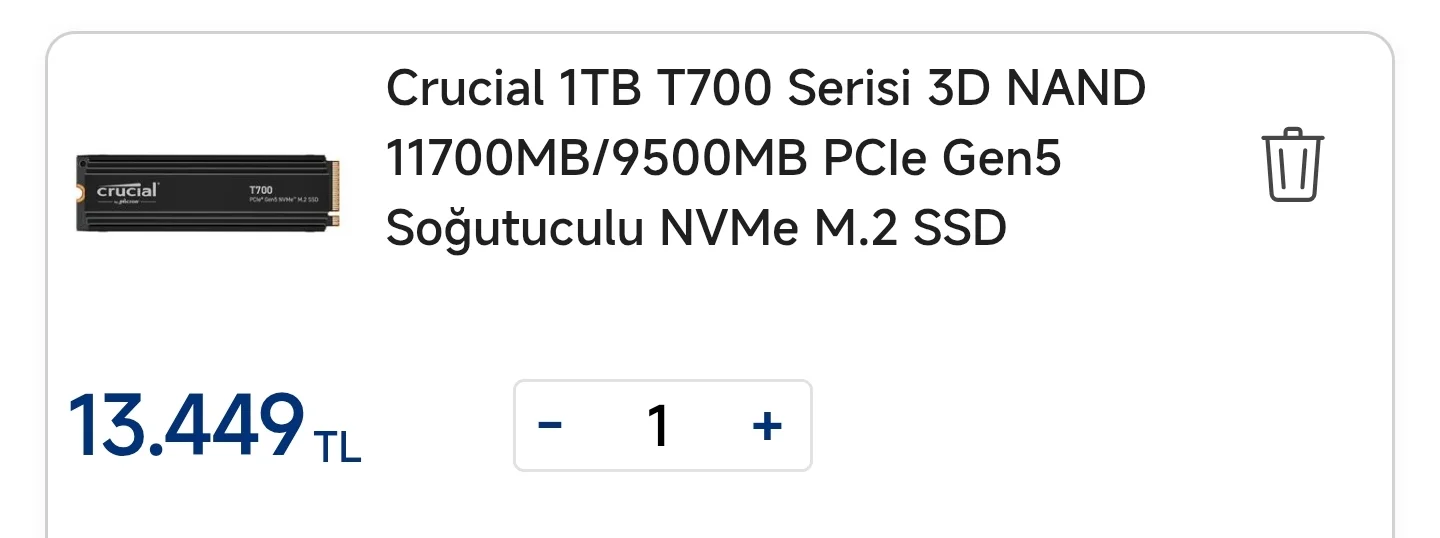
Vatan'dan da şu ssd'yi buldum iyi gibi
Daha PSU, kasa ve işlemci soğutucuyu seçmedim, küçük bir ATX kasa ve kaliteli bir PSU ve iyi bir işlemci soğutucu önerirseniz sevinirim (Amazon/Teknosa/Vatan/Mediamarkt'dan önerirseniz sevinirim)
Ayrıca kupon kodu verirseniz sevinirim
Ve ikinci el de tercih edebilirim önericekseniz kesinlikle Konya üzerinde bulunması lazım
@flyingatm hocam sizce kabul edilebilir bir performans alabilir miyim? @Remi hocam sizde konuyu takip edin belki işinize yarar (Geçenlerde buna benzer bir konu açmıştın ondan etiketledim)
Açıkçası tatmin edeceğini hiç sanmıyorum. iGPU'larla VRAM sağlanabiliyor ama NPU olsa bile performansı yetersiz kalıyor; her şey vram değil çünkü. Beklentinize bağlı tamamen.
Daha PSU, kasa ve işlemci soğutucuyu seçmedim, küçük bir ATX kasa ve kaliteli bir PSU ve iyi bir işlemci soğutucu önerirseniz sevinirim (Amazon/Teknosa/Vatan/Mediamarkt'dan önerirseniz sevinirim)
Ayrıca kupon kodu verirseniz sevinirim
Ve ikinci el de tercih edebilirim önericekseniz kesinlikle Konya üzerinde bulunması lazım
@flyingatm hocam sizce kabul edilebilir bir performans alabilir miyim? @Remi hocam sizde konuyu takip edin belki işinize yarar (Geçenlerde buna benzer bir konu açmıştın ondan etiketledim)
yani anlamsız sanki eğer hevesiniz varsa vast.ai dan vb linux sunucular kiralayıp bence birkaç dolara hevesinizi giderin içinde yapay zeka vb çalıştırıp.
Daha PSU, kasa ve işlemci soğutucuyu seçmedim, küçük bir ATX kasa ve kaliteli bir PSU ve iyi bir işlemci soğutucu önerirseniz sevinirim (Amazon/Teknosa/Vatan/Mediamarkt'dan önerirseniz sevinirim)
Ayrıca kupon kodu verirseniz sevinirim
Ve ikinci el de tercih edebilirim önericekseniz kesinlikle Konya üzerinde bulunması lazım
@flyingatm hocam sizce kabul edilebilir bir performans alabilir miyim? @Remi hocam sizde konuyu takip edin belki işinize yarar (Geçenlerde buna benzer bir konu açmıştın ondan etiketledim)
128 bit DDR5 erişimi pek iş yapmaz bence, bu parayla Ai sistemi kuracak olsam büyük ihtimalle Mac Studio M4 Max 36GB bakardım. Windows tarafında olacaksa da ekran kartına ağırlık verir kalan bileşenleri ona ayak uydurabilecek temel düzeyde tutardım.
Açıkçası tatmin edeceğini hiç sanmıyorum. iGPU'larla VRAM sağlanabiliyor ama NPU olsa bile performansı yetersiz kalıyor; her şey vram değil çünkü. Beklentinize bağlı tamamen.
LLM çalıştırmak için en önemli şey kullanılan belleğin bant genişliği. Tek başına 48GB olması bir anlam ifade etmiyor, evet model sığar ama model çalışırken de her kelime seçimi için tüm belleği okumak isteyecek, eğer bellek yavaşsa token üretimi aşırı yavaş kalır o da kullanılabilir/katlanılabilir seviyede olmaz.
Daha PSU, kasa ve işlemci soğutucuyu seçmedim, küçük bir ATX kasa ve kaliteli bir PSU ve iyi bir işlemci soğutucu önerirseniz sevinirim (Amazon/Teknosa/Vatan/Mediamarkt'dan önerirseniz sevinirim)
Ayrıca kupon kodu verirseniz sevinirim
Ve ikinci el de tercih edebilirim önericekseniz kesinlikle Konya üzerinde bulunması lazım
@flyingatm hocam sizce kabul edilebilir bir performans alabilir miyim? @Remi hocam sizde konuyu takip edin belki işinize yarar (Geçenlerde buna benzer bir konu açmıştın ondan etiketledim)
Hocam sistem teoride çalışır ancak masaüstü işlemcilerin destekledikleri bant genişliklerinin zayıflığından ötürü böyle bir sistem kurmaktan vazgeçmiştim.
Uzun süredir yaptığım araştırmalara istinaden şöyle söyleyebilirim. Bu iş için ilk metod sağlam ekran kartlarıyla mining rig gibi bir rig kurarak yapmak bu en hızlı metod onun dışında yukarda @Tablet123 'ün önerdiği gibi mac üzerine kurmak. Ortalamada ekran kartı ile kurulan bir rig maclerden 2x daha hızlı çalışıyor.
Windows tarafında bunun en iyi muadili Ryzen AI laptop işlemcileri ancak onlar ancak macbookların yarısı kadar bant genişliğine ulaşabiliyor. Şu an kurmak istediğiniz sistem ise bant genişliği olarak Ryzen AI'lerin yarısı
Kısaca şöyle bir tablo var
Ekran kartlı rig 2x>> Mac bilgisayarlar 2x>> Ryzen AI işlemciler 2x>> Attığınız işlemci
Yani bant genişliği çok çok daha kısıtlı bu saniyede aldığınız token miktarını ciddi şekilde kısıtlıyor.
Kendim konuyu açmadan önce de açtıktan sonra da araştırmaya devam ettim buna istinaden 3060 x 4 bir sistem kurmaya karar verdim ancak detayları araştırdıkça bu işten vazgeçmeye karar verdim.
Karışık şekilde sebeplerini yazayım bilgisayarda olmadığımdan çok özenli yazamıyorum kusuruma bakmayın.
Local LLM'de çalıştırabildiğiniz alt ajan sayısı bu dolaylarda bir sistemde maksimum 2. 2'den fazlasını çalıştırınca o verimi alamıyorsunuz. Bu yüzden yaptırdığınız işlem bulutta çalışan modellerden çok daha uzun sürüyor. Ayrıca muhtemelen çalıştıracağınız Qwen modeli muadili olarak görülen Gpt Luna ve Haiku modellerinden 4-5kat fazla token yakıyor işlem başına. Sonuçta lokal model token sayısının ne önemi var diye düşünmeyin kurduğunuz sistemin bant genişliği dar olduğundan her token için çok daha fazla süre beklemeniz gerekiyor. Bunların üstüne zaten sistem için tonla ücret ödenmişken kuracağınız sistem gerek elektrik faturalarıyla gerek zamandan kaybınızla ve gerek önceden yapmanız gereken yatırımla gpt luna gibi modelleri kullanmaktan çok daha pahalıya geliyor.
@flyingatm hocamın önerisinden sonra kendim ufak bir hybrid model kurdum macbookda ufak bir model çalıştırıyorum birkaç işi o yapıyor geri kalan işi openrouter üzerinden eski qwen flash modellerini neredeyse bedava çalıştırarak yapıyorum böyle bir sistem kurmak her şekilde bana daha mantıklı geliyor. Eğer AI sistemi kurmakta kararlıysanız bence maclere veya rig sistemine yönelin. Eski uygun fiyatlı ekran kartlarıyla bir rig kurabilirsiniz alacağınız bant genişliği en azından şu ankinin 4-5 katı civarında olacaktır.
Maalesef mesajı yazdığım zaman itibariyle localde AI çalıştırmak eğer Alican Kirazlar Mesut Çevikler gibi 512gb vraminiz vs yoksa işlevsiz kalıyor. Frontier model çalıştıramadıktan sonra çokta bir olayı kalmadı benim için. Bu yüzden kendime mini bir pc topluyorum şu anda.
Önceden Ryzen AI işlemcili şu anki linkini attığınız sistemin 2x bant genişliğine sahip bir laptop kullanıyordum. Token hızlarından hiç mi hiç memnun değildim bunun yarısını düşünmek bile çok istemiyorum hocam. Umarım faydası olmuştur
Süre mevzusuna çok değinmemişim 2 alt ajan demek zulüm demek gerçekten Gpt Lunanın 10-20 alt ajan çalıştırdığı yerde 2 alt ajan demek 5-10 kat yavaşlık demek bunu eski laptopumda yaşıyordum Qwen 3.8 modelini tek ajan olarak çalıştırabiliyordum Gptnin 5 dkda yaptığı iş için 50-60dk beklemem gerektiği oldu gerçekten dayanılacak bir şey değil maalesef.
Tek kullanılabilir alanı sansürsüz LLM modellerine ihtiyaç duyuyorsanız zaten tek alternatifiniz sayılır. Ancak sansürsüz model için böyle bir masrafa değer mi sanmıyorum
Hocam sistem teoride çalışır ancak masaüstü işlemcilerin destekledikleri bant genişliklerinin zayıflığından ötürü böyle bir sistem kurmaktan vazgeçmiştim.
Uzun süredir yaptığım araştırmalara istinaden şöyle söyleyebilirim. Bu iş için ilk metod sağlam ekran kartlarıyla mining rig gibi bir rig kurarak yapmak bu en hızlı metod onun dışında yukarda @Tablet123 'ün önerdiği gibi mac üzerine kurmak. Ortalamada ekran kartı ile kurulan bir rig maclerden 2x daha hızlı çalışıyor.
Windows tarafında bunun en iyi muadili Ryzen AI laptop işlemcileri ancak onlar ancak macbookların yarısı kadar bant genişliğine ulaşabiliyor. Şu an kurmak istediğiniz sistem ise bant genişliği olarak Ryzen AI'lerin yarısı
Kısaca şöyle bir tablo var
Ekran kartlı rig 2x>> Mac bilgisayarlar 2x>> Ryzen AI işlemciler 2x>> Attığınız işlemci
Yani bant genişliği çok çok daha kısıtlı bu saniyede aldığınız token miktarını ciddi şekilde kısıtlıyor.
Kendim konuyu açmadan önce de açtıktan sonra da araştırmaya devam ettim buna istinaden 3060 x 4 bir sistem kurmaya karar verdim ancak detayları araştırdıkça bu işten vazgeçmeye karar verdim.
Karışık şekilde sebeplerini yazayım bilgisayarda olmadığımdan çok özenli yazamıyorum kusuruma bakmayın.
Local LLM'de çalıştırabildiğiniz alt ajan sayısı bu dolaylarda bir sistemde maksimum 2. 2'den fazlasını çalıştırınca o verimi alamıyorsunuz. Bu yüzden yaptırdığınız işlem bulutta çalışan modellerden çok daha uzun sürüyor. Ayrıca muhtemelen çalıştıracağınız Qwen modeli muadili olarak görülen Gpt Luna ve Haiku modellerinden 4-5kat fazla token yakıyor işlem başına. Sonuçta lokal model token sayısının ne önemi var diye düşünmeyin kurduğunuz sistemin bant genişliği dar olduğundan her token için çok daha fazla süre beklemeniz gerekiyor. Bunların üstüne zaten sistem için tonla ücret ödenmişken kuracağınız sistem gerek elektrik faturalarıyla gerek zamandan kaybınızla ve gerek önceden yapmanız gereken yatırımla gpt luna gibi modelleri kullanmaktan çok daha pahalıya geliyor.
@flyingatm hocamın önerisinden sonra kendim ufak bir hybrid model kurdum macbookda ufak bir model çalıştırıyorum birkaç işi o yapıyor geri kalan işi openrouter üzerinden eski qwen flash modellerini neredeyse bedava çalıştırarak yapıyorum böyle bir sistem kurmak her şekilde bana daha mantıklı geliyor. Eğer AI sistemi kurmakta kararlıysanız bence maclere veya rig sistemine yönelin. Eski uygun fiyatlı ekran kartlarıyla bir rig kurabilirsiniz alacağınız bant genişliği en azından şu ankinin 4-5 katı civarında olacaktır.
Maalesef mesajı yazdığım zaman itibariyle localde AI çalıştırmak eğer Alican Kirazlar Mesut Çevikler gibi 512gb vraminiz vs yoksa işlevsiz kalıyor. Frontier model çalıştıramadıktan sonra çokta bir olayı kalmadı benim için. Bu yüzden kendime mini bir pc topluyorum şu anda.
Önceden Ryzen AI işlemcili şu anki linkini attığınız sistemin 2x bant genişliğine sahip bir laptop kullanıyordum. Token hızlarından hiç mi hiç memnun değildim bunun yarısını düşünmek bile çok istemiyorum hocam. Umarım faydası olmuştur
Mesaj otomatik olarak birleştirildi:
Süre mevzusuna çok değinmemişim 2 alt ajan demek zulüm demek gerçekten Gpt Lunanın 10-20 alt ajan çalıştırdığı yerde 2 alt ajan demek 5-10 kat yavaşlık demek bunu eski laptopumda yaşıyordum Qwen 3.8 modelini tek ajan olarak çalıştırabiliyordum Gptnin 5 dkda yaptığı iş için 50-60dk beklemem gerektiği oldu gerçekten dayanılacak bir şey değil maalesef.
Tek kullanılabilir alanı sansürsüz LLM modellerine ihtiyaç duyuyorsanız zaten tek alternatifiniz sayılır. Ancak sansürsüz model için böyle bir masrafa değer mi sanmıyorum
Fiyattan bağımsız; 3080, 3090 Ti gibi ikinci el GPU'ları birleştirip 900-1000 GB/s bant genişliği seviyelerine ulaşamadıktan sonra (27B civarı düzgün bir modeli ancak o kadar bant genişliğiyle, özellikle bağlam genişledikçe "evet bu işimi görüyor" hızlarında kullanabilirsiniz), bence çok önemli verilerin olduğu işlemlerin asenkron yapılması lazım.
Benim şahsi görüşüm; birçok insanın lokal AI'da yazılımsal altyapının ne kadar önemli olduğunu ve altyapı modelle (modelin mimarisi ve davranışsal yapısıyla) uyumsuz olduğunda hem gecikme hem de yüksek token tüketimi gibi sorunlara yol açacağını görmemesi. Şu anda açık kaynak altyapılardan tutun Dify gibi sistemlere kadar hepsinin temel sorunu, her işi yapmaya çalıştıkları için model mimarisiyle uyumsuz, kalitesiz ve bug'larla dolu çalışmaları. Gizlilik takıntısı yoksa gündelik kullanımda insanı gerçekten kanser edebiliyor.
Bence altyapı ve context management tarafı her şeyden çok daha önemli. Orayı çözebildiğin zaman, modeli hızlı çalıştıramıyorsan bile asenkron çalışırsın; dışarıya sızmasını istemediğin veya gizli kalması gereken bilgileri orada işlersin. Gündelik işlerini ise yine commercial AI servislerinden halledersin. En mantıklı orta yolu bu gibi görüyorum ben.
Hocam sistem teoride çalışır ancak masaüstü işlemcilerin destekledikleri bant genişliklerinin zayıflığından ötürü böyle bir sistem kurmaktan vazgeçmiştim.
Uzun süredir yaptığım araştırmalara istinaden şöyle söyleyebilirim. Bu iş için ilk metod sağlam ekran kartlarıyla mining rig gibi bir rig kurarak yapmak bu en hızlı metod onun dışında yukarda @Tablet123 'ün önerdiği gibi mac üzerine kurmak. Ortalamada ekran kartı ile kurulan bir rig maclerden 2x daha hızlı çalışıyor.
Windows tarafında bunun en iyi muadili Ryzen AI laptop işlemcileri ancak onlar ancak macbookların yarısı kadar bant genişliğine ulaşabiliyor. Şu an kurmak istediğiniz sistem ise bant genişliği olarak Ryzen AI'lerin yarısı
Kısaca şöyle bir tablo var
Ekran kartlı rig 2x>> Mac bilgisayarlar 2x>> Ryzen AI işlemciler 2x>> Attığınız işlemci
Yani bant genişliği çok çok daha kısıtlı bu saniyede aldığınız token miktarını ciddi şekilde kısıtlıyor.
Kendim konuyu açmadan önce de açtıktan sonra da araştırmaya devam ettim buna istinaden 3060 x 4 bir sistem kurmaya karar verdim ancak detayları araştırdıkça bu işten vazgeçmeye karar verdim.
Karışık şekilde sebeplerini yazayım bilgisayarda olmadığımdan çok özenli yazamıyorum kusuruma bakmayın.
Local LLM'de çalıştırabildiğiniz alt ajan sayısı bu dolaylarda bir sistemde maksimum 2. 2'den fazlasını çalıştırınca o verimi alamıyorsunuz. Bu yüzden yaptırdığınız işlem bulutta çalışan modellerden çok daha uzun sürüyor. Ayrıca muhtemelen çalıştıracağınız Qwen modeli muadili olarak görülen Gpt Luna ve Haiku modellerinden 4-5kat fazla token yakıyor işlem başına. Sonuçta lokal model token sayısının ne önemi var diye düşünmeyin kurduğunuz sistemin bant genişliği dar olduğundan her token için çok daha fazla süre beklemeniz gerekiyor. Bunların üstüne zaten sistem için tonla ücret ödenmişken kuracağınız sistem gerek elektrik faturalarıyla gerek zamandan kaybınızla ve gerek önceden yapmanız gereken yatırımla gpt luna gibi modelleri kullanmaktan çok daha pahalıya geliyor.
@flyingatm hocamın önerisinden sonra kendim ufak bir hybrid model kurdum macbookda ufak bir model çalıştırıyorum birkaç işi o yapıyor geri kalan işi openrouter üzerinden eski qwen flash modellerini neredeyse bedava çalıştırarak yapıyorum böyle bir sistem kurmak her şekilde bana daha mantıklı geliyor. Eğer AI sistemi kurmakta kararlıysanız bence maclere veya rig sistemine yönelin. Eski uygun fiyatlı ekran kartlarıyla bir rig kurabilirsiniz alacağınız bant genişliği en azından şu ankinin 4-5 katı civarında olacaktır.
Maalesef mesajı yazdığım zaman itibariyle localde AI çalıştırmak eğer Alican Kirazlar Mesut Çevikler gibi 512gb vraminiz vs yoksa işlevsiz kalıyor. Frontier model çalıştıramadıktan sonra çokta bir olayı kalmadı benim için. Bu yüzden kendime mini bir pc topluyorum şu anda.
Önceden Ryzen AI işlemcili şu anki linkini attığınız sistemin 2x bant genişliğine sahip bir laptop kullanıyordum. Token hızlarından hiç mi hiç memnun değildim bunun yarısını düşünmek bile çok istemiyorum hocam. Umarım faydası olmuştur
Mesaj otomatik olarak birleştirildi:
Süre mevzusuna çok değinmemişim 2 alt ajan demek zulüm demek gerçekten Gpt Lunanın 10-20 alt ajan çalıştırdığı yerde 2 alt ajan demek 5-10 kat yavaşlık demek bunu eski laptopumda yaşıyordum Qwen 3.8 modelini tek ajan olarak çalıştırabiliyordum Gptnin 5 dkda yaptığı iş için 50-60dk beklemem gerektiği oldu gerçekten dayanılacak bir şey değil maalesef.
Tek kullanılabilir alanı sansürsüz LLM modellerine ihtiyaç duyuyorsanız zaten tek alternatifiniz sayılır. Ancak sansürsüz model için böyle bir masrafa değer mi sanmıyorum
1- Sansürsüz model lazımsa.
2- Yapay zeka ile paylaşılacak bilgiler başka biriyle paylaşılmaması gereken bilgilerse (şirketin önemli finansal hareketlerini düzenleyen bir Ai ajanı gibi)
Bu ikisi hariç “şuan için” lokal llm çok mantıklı değil. Bence ilerde mantıklı olacak o ayrı ama o da şuanki donanım ile olmayacak, RTX Spark gibi ama belki ondan kat kat iyi LLM çalıştırabilen çipler çıkar birkaç yıla.
İlerde illa bir AI zammı gelecek elimde yüksek bir bütçe olsa gider frontier model çalıştırabilecek bir sistem kurardım şahsen ama o bütçe çoğumuzda yok maalesef
Dediğiniz tarz çiplerinde son kullanıcıya ulaşması çok zor maalesef Spark faciası bunu net şekilde önümüze sermiştir ama inşallah tam tersi olur
Şuan Ai firmalarının talebi yüzünden ve yeni üretim tesisi kurmak hemen birkaç yılda yapılamadığından kullanıcıya Ram kalmıyor. İlerde kalacak, hem şirketler doyacak ilerleme ivmesi azalıp talep düşecek hem Ram tarafında geleceği gören firmaların yapacağı yatırımlar üretime dönüşmeye başlayacak. O noktada fazladan üretilen RAMlerin müşterisi tabi ki biz olacağız ve firmalar eğer bize standart 32GB Ramli bilgisayarlar yerine 256GB Ramli bir tane almaya ikna etmek isterse (ki piyasada Ram bollaşırsa isteyecektir) böyle çipler de bolca üretilir.
Bu 1-2 senelik bir süreç değil ama biraz daha ileri bir gelecek, o konuda uyarayım
Hocam şirketlerin doyması pek mümkün değil atladığınız detay bu veri merkezlerinde ramlerin ömrü 3 hatta 2 yıla kadar düşebiliyor bu sektör büyümeye devam ettikçe şirketler yeni ramler almaya da devam edecek ve eldekilerde hızlı bozulduğundan biz uzun bir süre avcumuzu yalayacağız muhtemelen
Hocam şirketlerin doyması pek mümkün değil atladığınız detay bu veri merkezlerinde ramlerin ömrü 3 hatta 2 yıla kadar düşebiliyor bu sektör büyümeye devam ettikçe şirketler yeni ramler almaya da devam edecek ve eldekilerde hızlı bozulduğundan biz uzun bir süre avcumuzu yalayacağız muhtemelen
Ben bu yüzden konu lokal AI olunca hız değil kalite aramaya başladım. Yüksek bant genişliğini ucuza bulmak çok zor, ama kapasite en azından pazarlık edilebiliyor. Kapasiteye basın geçin yani
YTD diyelim de sonra başımıza bir iş gelir